架构设计
Sirchmunk 采用清晰分离的层次化架构,遵循关注点分离原则。
系统概览
LENS 框架
LENS(Latent Evidence Exploration and Search,隐式证据探索与搜索)是一个无索引检索框架,将上下文内搜索形式化为在动态原始文档诱导的隐式证据空间上进行预算约束的证据定位。LENS 无需通过嵌入索引或分块存储预物化证据,而是维护一个查询条件化的候选证据置信度,并迭代地:
- 通过互补的词法、局部和探索性提案策略提议候选项
- 经由 LLM 相关性预言机更新置信度
- 在可控 token 预算下向高后验区域收敛
这一形式化使搜索过程具备自适应性、预算感知能力,并完全基于源文档——无需任何预构建的索引基础设施。
论文: LENS: In-Context Search via Latent Evidence Exploration over Dynamic Raw Documents(arXiv 2026)
知识图谱
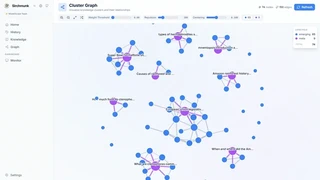
知识图谱提供了自进化知识簇的交互式可视化,这些知识簇从搜索交互中增量构建。基于 Cytoscape.js 实现,它展示:
- 知识簇关系 — 连接相关知识单元的语义边
- 生命周期状态 — 萌芽 → 稳定 → 弃用 转换的可视化编码
- Leiden 元聚类 — 通过 Leiden 算法发现的更高层级社区结构
用户可以直接在 Web UI 中探索、筛选和深入查看知识簇。
参见知识进化展示,了解知识聚类如何随时间演化的动画演示。
核心组件
| 组件 | 说明 |
|---|---|
| AgenticSearch | 搜索编排器,支持 FAST / DEEP / FILENAME_ONLY 模式与预算感知的证据定位 |
| KnowledgeBase | 将源头证据簇持久化为可复用的热先验,供后续查询使用 |
| EvidenceProcessor | 将候选区域整合为紧凑、可追溯的证据单元 |
| GrepRetriever | 高性能 无索引 文件检索,支持并行处理 |
| OpenAIChat | 统一 LLM 接口,支持流式与用量统计 |
| KnowledgeCompiler | 离线文档编译为树索引和知识簇(Beta) |
| KnowledgeLint | 知识健康检查与自动修复 |
| MonitorTracker | 实时系统与应用指标采集 |
多阶段搜索管线
Sirchmunk 的核心是一个多阶段搜索管线,其设计原则是每个阶段内最大并行化与阶段之间严格的依赖关系。
阶段 0 — 知识簇复用
在任何计算开始之前,系统会检查是否有语义相似的查询已被回答过。将查询的轻量级嵌入通过余弦相似度与存储的知识簇进行比较。如果找到近似匹配(超过可配置的相似度阈值),缓存的知识簇会立即返回——为重复或改述的查询提供亚秒级响应时间。
这不仅仅是缓存——它是知识复利积累的起点。每次复用都会将新查询追加到知识簇的历史中,让系统记住哪些问题导向了哪些洞见。
阶段 1 — 并行探测
多个独立的探测并发启动,收集多样化信号:
- LLM 关键词提取 — LLM 将查询分解为多层级关键词,从粗粒度(高召回)到细粒度(高精度),每个关键词附带稀有度评分。
- 目录结构扫描 — 遍历文件系统收集路径元数据:文件名、大小、修改时间和内容预览——这是利用结构线索进行智能推断的基础。
- 知识缓存查找 — 在现有知识簇中进行部分匹配搜索,复用先前获取的知识。
- 编译产物加载 — 加载可用的预计算树索引、主题图和摘要索引。
阶段 2 — 多路 DEEP 检索
v0.2.0 中,DEEP 模式并行运行 5 条互补检索路径:
| 路径 | 信号 |
|---|---|
| 词法路径 | IDF 加权关键词搜索原始文件内容 |
| 实体路径 | 命名实体和标识符的精确匹配查找 |
| 目录路径 | 基于 LLM 引导的元数据评估进行结构排序 |
| 结构路径 | 利用编译产物的启发式文档树导航 |
| 主题图路径 | 跨文档主题图遍历,用于多跳发现 |
所有路径的结果通过**置信度加权的倒数排名融合(RRF)**进行融合。软路由折叠机制会动态禁用低收益路径——当单一路径以高置信度和强边际达成共识时,其余路径被折叠以减少延迟和 token 消耗,同时保持回答质量。
阶段 3 — 证据定位与知识簇构建
结果被合并、去重,并通过预算约束的证据定位处理。LLM 将证据片段合成为结构化的知识簇。
阶段 4 — 摘要或 ReAct 精炼
- 找到证据 → LLM 生成带有源头链接证据的结构化简报
- 未找到证据 → ReAct 智能体启动,使用跳数感知策略进行迭代探索
阶段 5 — 持久化
有价值的知识簇连同其嵌入一起保存,供未来复用。
核心算法
预算约束的证据探索
传统检索系统要么读取完整文档,要么依赖固定大小的分块,导致 Token 浪费或上下文丢失。LENS 将相关证据视为隐式且查询条件化的:系统首先以低成本形成关于可能证据区域的先验,然后仅在最有价值的观测位置花费 LLM 调用。
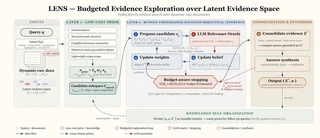
该工作流分为三个层次:
低成本先验: 词法锚点、文档路径结构、编译摘要、历史源头证据和轻量级语料库扫描,在昂贵的预言机调用之前缩小候选子空间。
预算约束的序贯推断: 提议候选区域,由 LLM 相关性预言机进行观测,并用于更新置信状态,直到预算感知的停止规则判定证据充分。
整合与合成: 选定区域被合并为紧凑的源头证据集,合成为答案,并可选地持久化为可复用知识供后续查询使用。
核心特性:
- 基于原始文档的无索引搜索: 可直接在动态文件上运行搜索,无需预物化持久化嵌入或分块索引。
- 源头可追溯: 最终答案附带可追溯的证据区域,而非不透明的向量命中。
- 预算感知: LLM 调用自适应地花费在不确定或高价值的证据区域上,并提供显式的成本和延迟遥测。
ReAct 智能体
自主的"思考 → 行动 → 观察"循环:
- 优先工具策略(关键词搜索 → 文件读取 → 知识查询 → 目录扫描)
- 双预算机制(Token 预算 + 循环次数)
- 记忆已探索的途径
自进化知识簇(Knowledge Cluster)
Sirchmunk 不会在回答完查询后丢弃搜索结果。相反,每次搜索都会产生一个 KnowledgeCluster(知识簇)——一个结构化、可复用的知识单元,随着使用不断变得更加智能。这正是系统具备_自进化_能力的核心机制。
什么是 KnowledgeCluster?
KnowledgeCluster 是一个丰富标注的对象,完整记录了单次搜索周期的认知产出:
| 字段 | 用途 |
|---|---|
| Evidences(证据) | 通过 LENS 定位的源文件证据区域,包含文件路径、摘要和原始文本 |
| Content(内容) | LLM 合成的结构化 Markdown 分析,附带引用 |
| Patterns(模式) | 从证据中提炼的 3–5 条设计原则或核心机制 |
| Confidence(置信度) | 共识评分 \[0, 1\],指示知识簇的可靠性 |
| Queries(查询历史) | 贡献或复用该知识簇的历史查询(FIFO,最多 5 条) |
| Hotness(热度) | 反映查询频率和时效性的活跃度评分 |
| Embedding(嵌入向量) | 由累积查询生成的 384 维向量,用于语义检索 |
生命周期:从创建到进化
 ┌─────── 新查询 ───────┐
 │                       ▼
 │     ┌───────────────────────────────┐
 │     │  阶段 0:语义复用             │──── 匹配命中 ──→ 返回缓存知识簇
 │     │  (余弦相似度 ≥ 0.85)         │                  + 更新热度/查询/嵌入
 │     └──────────┬────────────────────┘
 │           未匹配
 │                ▼
 │     ┌───────────────────────────────┐
 │     │  阶段 1–3:完整搜索           │
 │     │  (关键词 → 检索 →            │
 │     │   证据定位 → LLM 合成)       │
 │     └──────────┬────────────────────┘
 │                ▼
 │     ┌───────────────────────────────┐
 │     │  构建新知识簇                 │
 │     │  确定性 ID: C{sha256}         │
 │     └──────────┬────────────────────┘
 │                ▼
 │     ┌───────────────────────────────┐
 │     │  阶段 5:持久化               │
 │     │  嵌入查询 → DuckDB →         │
 │     │  Parquet(原子写入同步)       │
 └─────└───────────────────────────────┘
复用检查(阶段 0): 在任何检索开始之前,查询会被嵌入并通过余弦相似度与所有已存储知识簇进行比对。若发现高置信度匹配,系统直接返回已有知识簇——完全省去 LLM 推理和搜索开销。
创建(阶段 1–3): 当无复用匹配时,完整管线运行:关键词提取、文件检索、预算约束证据定位、LLM 合成,最终生成新的
KnowledgeCluster。持久化(阶段 5): 知识簇存储在内存中的 DuckDB 表中,并定期刷写为 Parquet 文件。原子写入和基于文件修改时间的重载机制确保多进程安全。
复用时进化: 每当知识簇被复用时,系统会:
- 将新查询追加到知识簇的查询历史中(FIFO,最多 5 条)
- 提升热度(+0.1,上限 1.0)
- 基于更新后的查询集重新计算嵌入——扩展知识簇的语义覆盖范围
- 更新版本号和时间戳
核心特性
- 零成本加速: 重复或语义相似的查询直接从缓存知识簇获取答案,无需任何 LLM 推理,后续搜索几乎瞬时完成。
- 查询驱动的嵌入: 知识簇嵌入基于_查询_而非内容生成,确保检索与用户的实际提问方式对齐——而非文档的书写方式。
- 语义拓展: 随着多样化查询复用同一知识簇,其嵌入会漂移以覆盖更广的语义邻域,自然提升相关未来查询的召回率。
- 轻量级持久化: DuckDB 内存存储 + Parquet 磁盘持久化——无需外部数据库基础设施。后台守护线程同步,可配置刷写间隔,开销极小。
知识进化器
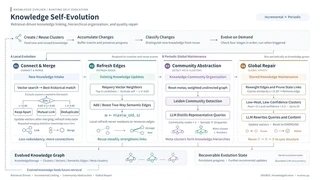
除了每次查询的知识簇创建和复用之外,KnowledgeEvolver 还会在后台运行四阶段周期,对整个知识图谱进行维护:
- 连接与合并 — 计算缓冲区中知识簇的两两相似度。相似度 ≥ 0.90 的知识簇被合并;相似度 ≥ 0.60 的建立跨聚类边,将相关查询的碎片化知识整合为一体。
- 边刷新 — 重新评估已有边,剪除陈旧连接,根据近期共查询模式和语义漂移更新权重。
- 元聚类发现 — Leiden 社区发现算法(通过 igraph 实现)识别更高阶结构——形成连贯知识社区的聚类群组,代表涌现式领域专长。
- 全局更新 — 在整个图谱中同步生命周期状态:持续被强化的知识簇从"萍芽"晋升为"稳定";孤立或被反驳的向"弃用"迁移。
整个周期由搜索活动触发(缓冲计数和步长间隔),异步运行。结果持久化至 DuckDB + Parquet,通过增量清单实现崩溃恢复。进化器绝不阻塞查询热路径。
数据存储
所有持久化数据存储在配置的 SIRCHMUNK_WORK_PATH(默认:~/.sirchmunk/):
{SIRCHMUNK_WORK_PATH}/
  ├── .cache/
    ├── history/              # 聊天会话历史(DuckDB)
    │   └── chat_history.db
    ├── knowledge/            # 知识簇(Parquet)
    │   └── knowledge_clusters.parquet
    ├── compile/              # 编译产物(Beta)
    │   ├── manifest.json     # 文件清单与哈希
    │   ├── document_catalog.json
    │   ├── summary_index.json
    │   ├── trees/            # 层次化树索引
    │   ├── table_digests/    # 表格提取摘要
    │   └── xlsx_digests/     # 电子表格摘要
    └── settings/             # 用户设置(DuckDB)
        └── settings.db
设计原则
Sirchmunk 遵循 SOLID 原则:
- 单一职责 — 每个组件有一个明确的用途
- 开放封闭 — 通过抽象扩展,而非修改
- 里氏替换 — 所有实现遵守抽象契约
- 接口隔离 — 最小化、聚焦的接口
- 依赖倒置 — 高层逻辑依赖抽象
欲了解全面的技术分析,请阅读 技术深度报告。
论文: LENS: In-Context Search via Latent Evidence Exploration over Dynamic Raw Documents(arXiv 2026)