知识自进化
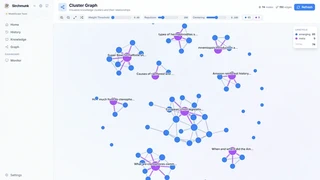 Sirchmunk 知识图谱
Sirchmunk 的知识体系并非静态的——它在持续进化。每一次搜索交互都会产生可复用的知识聚类,这些聚类随时间推移不断合并、拓展,最终形成更高层级的元社区。本页面展示了这一自进化知识架构及其交互式可视化。
知识自进化
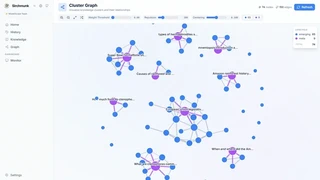
Web UI 的知识图谱页面基于 Cytoscape.js 构建,将聚类渲染为节点,相似度边和共查询边渲染为连接,并通过色彩编码区分生命周期状态:
- Emerging(新兴) — 刚形成的聚类,验证有限
- Stable(稳定) — 经多次查询持续强化的聚类
- Meta(元级) — 通过社区发现算法识别的高阶社区
- Deprecated(弃用) — 底层证据已不再支撑的聚类
- Contested(争议) — 存在冲突或矛盾证据的聚类
用户可以探索聚类详情、回溯证据至源文档,并观察知识拓扑如何在搜索会话间持续演化。
知识进化器架构
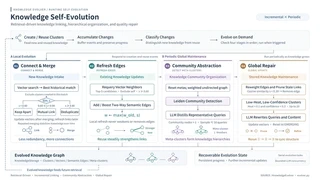
KnowledgeEvolver 编排了一个四阶段进化周期,由搜索活动触发,在后台异步运行:
阶段一 — 连接与合并
当新聚类在缓冲区中累积到一定数量,进化器计算两两相似度。相似度 ≥ 0.90 的聚类被合并;相似度 ≥ 0.60 的聚类之间建立跨聚类边。这将来自相关查询的碎片化知识整合为连贯的单元。
阶段二 — 边刷新
对已有边进行重新评估。陈旧或弱连接被剪枝,边权重根据近期共查询模式和语义漂移进行更新。这确保图谱拓扑与实际使用模式保持一致,而非停留在历史遗迹上。
阶段三 — 元聚类发现
Leiden 社区发现算法(通过 igraph 实现)识别更高阶的结构——形成连贯知识社区的聚类群组。这些元聚类代表了单个查询无法独立产生的涌现式领域专长。
阶段四 — 全局更新
生命周期状态在整个图谱中同步。持续被强化的聚类从"新兴"晋升为"稳定";孤立或被反驳的聚类向"弃用"状态迁移。版本号和时间戳同步更新以维护审计轨迹。
整个周期在预算约束下运行(LLM 并发信号量、缓冲区阈值),绝不阻塞查询热路径。结果持久化至 DuckDB + Parquet,并通过增量清单实现崩溃恢复。
知识进化实录
这段延时回放展示了在 4 篇文档上经 200 次查询后知识聚类的演化过程。你可以观察到孤立聚类如何涌现、通过共享证据建立连接、合并为整合的知识单元,最终形成元社区——全程无需人工干预。
设计理念
- 观测驱动,而非规则驱动:进化由实际搜索模式触发,而非预定义规则。系统通过观察哪些聚类被复用来学习哪些知识值得保留。
- 源头保真:知识进化改变的是导航效率——系统寻找证据所走的路径——但绝不改动源文档本身。每一个事实都可追溯至其原始位置。
- 有界成本:进化在预算约束下运行(LLM 并发信号量、缓冲区阈值),绝不阻塞查询热路径。
使用方式
知识进化默认开启。可通过环境变量或 SDK 参数 enable_knowledge_evolution 进行配置。
知识图谱可从 Web UI 侧边栏导航的 “Knowledge”(知识) 入口访问。聚类及其关系也可通过 Python SDK 进行编程查询。
